Apprendre aux robots à nous comprendre
Depuis des années, les robots sont excellents pour répéter une tâche précise, encore et encore, sans se tromper. Mais dès qu’il s’agit de coopérer avec une personne en chair et en os, les choses se compliquent. Un humain change d’avis, hésite, accélère, s’arrête net : autant de comportements qu’une machine peine à anticiper. C’est précisément ce défi qu’attaquent des chercheurs de l’université Carnegie Mellon, aux États-Unis, avec une nouvelle méthode d’apprentissage baptisée HALO (pour Heterogeneous-Agent Lyapunov Policy Optimization).
L’objectif est clair et plutôt réjouissant : obtenir des robots qui s’adaptent mieux à nous, plutôt que l’inverse. Au lieu de nous demander de nous plier au rythme d’une machine, HALO cherche à rendre le robot capable de composer avec notre part d’imprévu.
L’apprentissage par renforcement, expliqué simplement
Au cœur de HALO, on retrouve une technique bien connue en intelligence artificielle : l’apprentissage par renforcement. Le principe est facile à comprendre si on le compare au dressage d’un animal, ou à un jeu vidéo. Le robot essaie une action, observe le résultat, et reçoit une forme de « récompense » lorsqu’il se rapproche du but recherché. À force d’essais et d’erreurs, il finit par identifier les comportements qui fonctionnent le mieux.
La particularité de HALO, c’est qu’il mise sur l’apprentissage par renforcement dit multi-agent : plusieurs « acteurs » apprennent en même temps au sein d’une même scène. Ici, le robot n’apprend pas seul dans son coin ; il apprend à interagir et à coopérer avec un partenaire humain. De façon autonome, il découvre peu à peu comment ajuster ses gestes pour que l’équipe, humain et machine réunis, atteigne son objectif.
Le vrai casse-tête : l’imprévisibilité humaine
Pour entraîner un robot, on utilise généralement des simulations. Et c’est là que le bât blesse. Dans la plupart des simulations classiques, l’humain est modélisé comme une donnée « fixe », aux réactions prévisibles, comme un rouage qui ferait toujours la même chose. Problème : cela ne ressemble en rien à la réalité. Nous sommes spontanés, changeants, parfois carrément imprévisibles.
Résultat : un robot entraîné face à un humain « parfait » risque d’être désemparé dès qu’il rencontre une vraie personne. HALO prend le problème à bras-le-corps en intégrant cette imprévisibilité dès l’apprentissage. Le robot s’entraîne donc à composer avec un partenaire dont les actions ne sont pas écrites à l’avance, ce qui le prépare bien mieux au monde réel.
Une garantie de stabilité signée Lyapunov
Laisser un robot apprendre par essais et erreurs au contact d’un humain soulève évidemment une question de sécurité. Comment s’assurer que la machine ne va pas adopter de comportements erratiques ou dangereux pendant son apprentissage ? La réponse des chercheurs tient dans un outil mathématique éprouvé : la théorie de la stabilité de Lyapunov.
Sans entrer dans les équations, cette théorie offre une forme de garantie : elle permet de vérifier que le système converge bien vers un état stable, au lieu de partir dans tous les sens. Appliquée à HALO, elle assure que les apprentissages du robot et de l’humain se réorientent progressivement vers une trajectoire optimale pour l’équipe. C’est un peu comme un garde-fou invisible : il laisse de la liberté pour apprendre, tout en empêchant les dérapages.
Des applications très concrètes à l’horizon
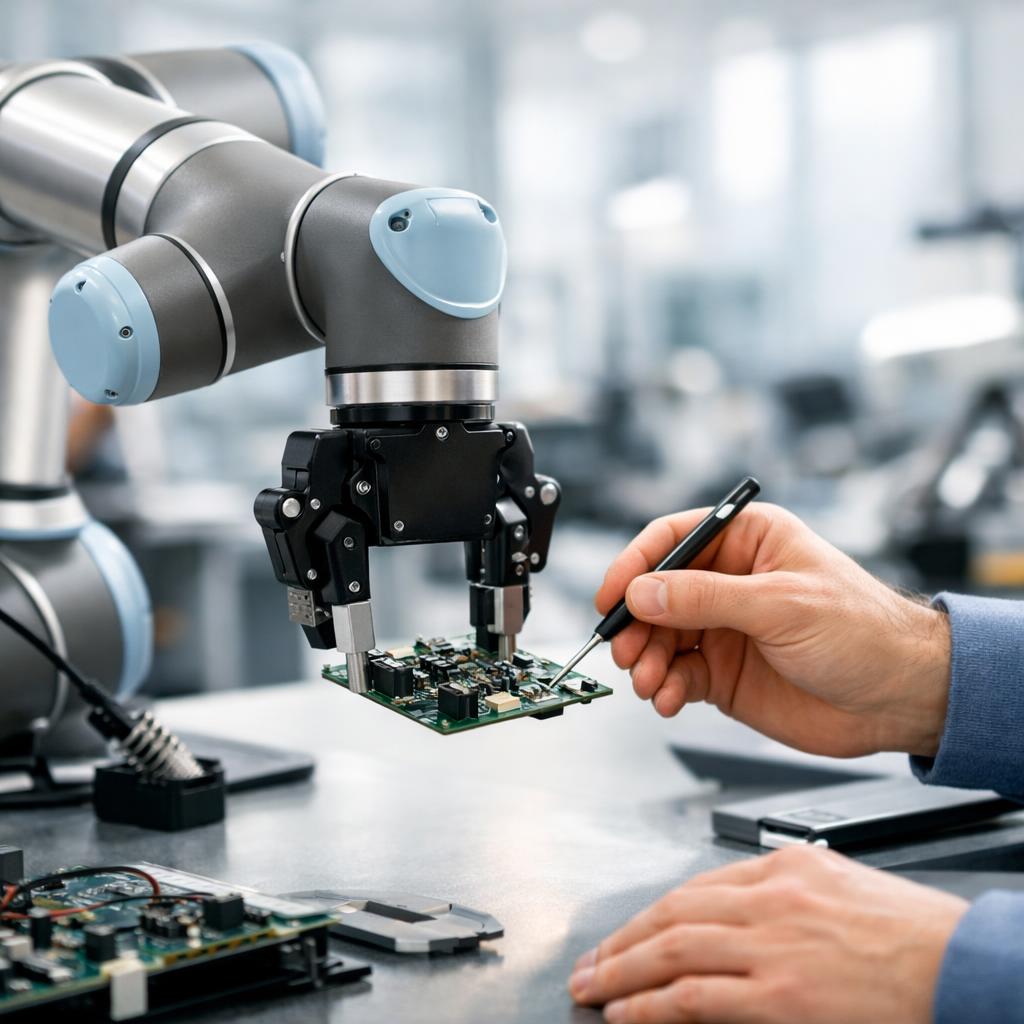
Si cette approche tient ses promesses, les usages potentiels sont nombreux. On pense d’abord aux cobots, ces robots collaboratifs qui partagent déjà l’espace de travail des ouvriers dans les usines : un robot capable de mieux anticiper les gestes de son collègue humain serait à la fois plus efficace et plus sûr.
D’autres domaines pourraient en bénéficier : la robotique d’assistance pour les personnes âgées ou en situation de handicap, les robots domestiques appelés à vivre dans nos foyers, ou encore la logistique, où machines et manutentionnaires se croisent en permanence.
Il faut toutefois rester mesuré. HALO est pour l’instant un travail de recherche, pas un produit grand public prêt à débarquer dans nos salons. Mais la direction est encourageante : elle dessine un futur où les robots apprendront à s’accorder à notre rythme, avec des garanties sérieuses de sécurité à la clé.
Ce qu’il faut retenir
- Des chercheurs de l’université Carnegie Mellon ont présenté HALO, une méthode pour améliorer la collaboration entre humains et robots.
- HALO repose sur l’apprentissage par renforcement multi-agent : le robot apprend seul, par essais et récompenses, à coopérer avec un humain.
- Son innovation : tenir compte de l’imprévisibilité humaine, trop souvent ignorée dans les simulations classiques.
- La théorie de la stabilité de Lyapunov sert de garde-fou mathématique pour assurer sécurité et stabilité pendant l’apprentissage.
- Applications visées : cobots en usine, robots d’assistance, robotique domestique et logistique ; il s’agit encore de recherche, pas d’un produit.